ハッカソンの授業でS評価とった私がやったこと
目次
- 何を作ったか
- 授業が始まる前に、テンプレートリポジトリを作っておいた
- ① Claudeに課金しよう
- 開発メンバーは全員AIエージェントを使っていた
- 夜間レビューを毎晩走らせた
- AIがチームの決定と個人提出物の矛盾を見つけた
- AIの提案を実測で棄却した
- AIが作った集計スクリプトを疑ったら、計測方式が間違っていた
- AI利用は隠さず申告した
- 課金で買えるのは「常時走らせられる状態」だけ
- ② コーディングを始める前に、規則と担当範囲を決めよう
- 担当は「人数」ではなく「コンポーネント」で切る
- 境界のデータフォーマットを先に確定する
- ファームウェアの中を分担するなら、関数レベルまで決める
- 決めたことはADRに残す
- 事故が起きてから作った規則もある
- 正直な話: 規則は書くだけでは守られない
- ③ 徹底的にGitHubで管理しよう
- 何でもGitに入れた
- 成果は最後のレポートで返ってきた
- 正直な話: 徹底できなかったこと
- ④ PlatformIOを使おう
- 一番のメリットは「誰のPCでもすぐ動く」
- platformio.iniが全部を明文化する
- PlatformIOが残り3本を支えている
- 実戦でいちばん大きかった穴 — public化
- 線引き表
- 見落としやすいのはこの3つ
- 機械で見る
- テンプレートを直したので、来年ぜひ使ってほしい
- ① EMA骨格を復活させた
- ② 「コーディング開始前に決めること」ガイドを足した
- ③ public前提の運用を組み込んだ
- ④ 「これは一例。変えてよい」と書いた
- 2リポジトリ体制にした
- 構成
- まとめ
大学の授業でハッカソンがあった。マイコン6台とPCで合奏するシステムを3か月かけて作り、S評価を取った。
何が効いたのかを終わってから振り返って、リポジトリの履歴を全部数え直した。886コミット、PR33件、ドキュメント85ページ。その履歴を見ながら「これは効いた」「これは効かなかった」を仕分けていくと、4つに絞れた。
- Claudeに課金しよう
- コーディングを始める前に、規則と担当範囲を明確にしよう
- 徹底的にGitHubで管理しよう
- PlatformIOを使おう
この4つは並列に並んでいるように見えて、実は下が上を支えている。PlatformIOという土台があるからGit管理とAI運用が成立する、という関係になっている。
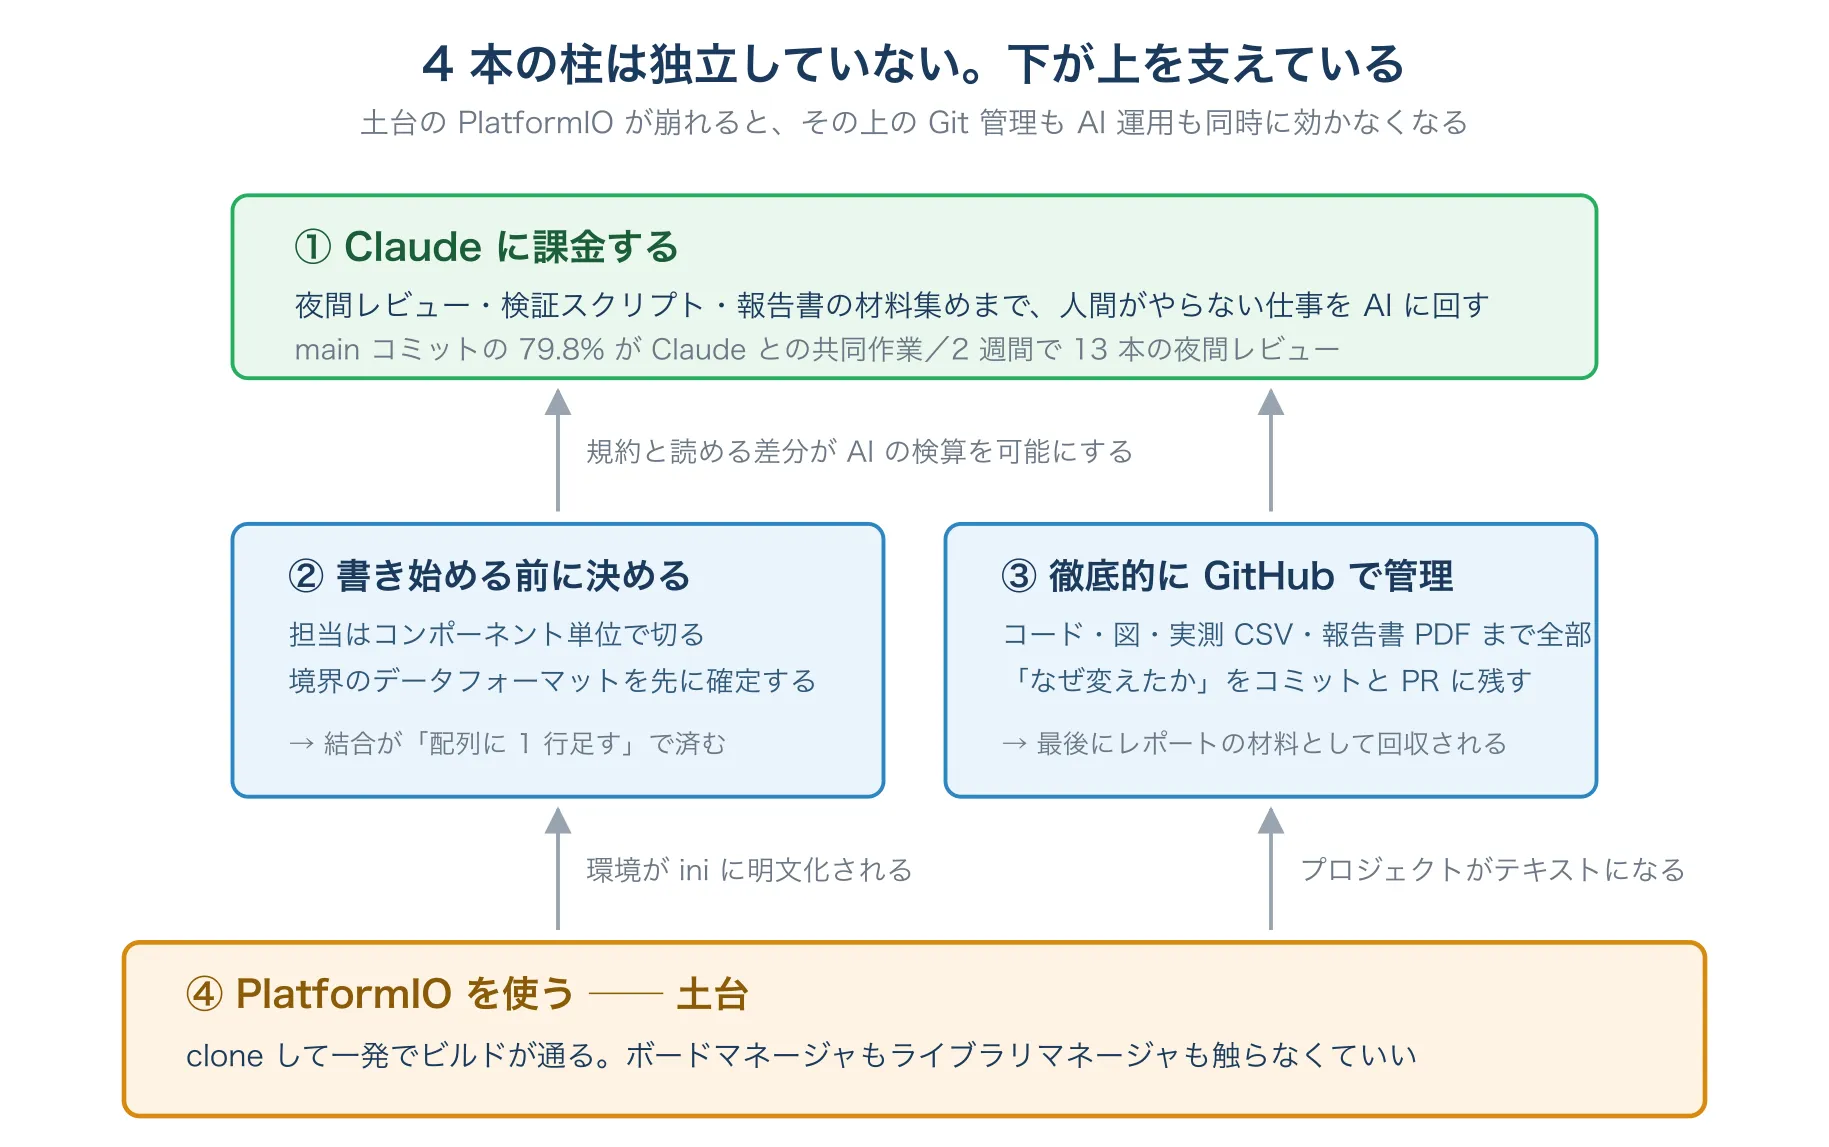
この記事では4つを実測値つきで説明したあと、うまくいかなかったことも同じ分量で書く。最後に、その学びを全部戻して直したテンプレートリポジトリを置いておく。来年この授業を受ける人がそのまま使える形にしてある。
何を作ったか
「指揮棒を振る速さでテンポを操作し、5台の楽器マイコンとPCで合奏するシステム」を作った。
- 指揮者ノード: XIAO ESP32-S3 Sense + IMU(GY-521)× 1台
- 楽器ノード: Arduino UNO R4 WiFi × 5台
- PCアプリ: Processing 4 + Minim
- 通信: SoftAP上のUDPマルチキャスト
技術的な山場は同期だった。SoftAPのUDPマルチキャストは、省電力端末向けのDTIMバッファリング(802.11の仕様由来)のせいで204.8ms周期のバースト配送になる。つまり「通信遅延30ms以内」は物理的に成立しない環境だった。
これをプログラムで吸収した。指揮者は拍を「220ms先の未来時刻」として予約送信し、楽器側はminフィルタによる時計同期で推定マスタ時計を持つ。届くのはバラバラでも、鳴るのは同時になる。
結果、受信が予約に間に合わなかった拍は45.4%から3.1%まで落ち、楽器間の発音時刻差は中央値7ms(目標20msの1/3)になった。
規模はこうなった。
| 項目 | 値 |
|---|---|
| 期間 | 3か月(コミットのあった日は63日) |
| コミット数(main) | 886 |
| PR | 33件(30マージ / 3クローズ) |
| ファームウェア | 239ファイル / 23,387行 |
| ドキュメント | 85ページ(Astro Starlight) |
| 最終報告書 | 64ページ |
授業が始まる前に、テンプレートリポジトリを作っておいた
チーム開発でいちばん時間が溶けるのは、決めていないことを走りながら決める時間だと思っている。フォルダ構成をどうするか、ブランチ名をどうするか、報告書をどうビルドするか。全部あとで決められるが、あとで決めると全員の作業が止まる。
なので授業が始まる前に、チーム開発用のテンプレートリポジトリを作っておいた。中身はこうだった。
- フォルダ構成(各フォルダにREADME付き。何を置く場所か・不要なら消してよいかを明記)
CONTRIBUTING.md(Git初学者向けのガイド。初版で429行)- PRテンプレート・Issueテンプレート3種
- GitHub ActionsでPlatformIO全ノードビルド
- LaTeX報告書の雛形とDev Container(Dockerでコンパイルが通る状態)
- PlatformIOプロジェクトの骨格
土台になった資産はもっと前から作ってあった。組込みの設計パターン(後述するEMA)は3月に、LaTeXのDockerコンパイル環境は2月に作ってある。テンプレートはそれを束ねたものだった。
そして実戦のリポジトリは、このテンプレートから作った。
ここで1つ大きなミスをしている。 テンプレートの初版にはEMAの骨格(IModule.h・SystemData.h・3フェーズループ入りのmain.cpp)が入っていたのに、「汎用化して他のテーマの班でも使えるようにしよう」と考えて全部削除した。代わりに置いたのは、足し算をするだけのExampleLibraryと、中身が空のsetup()/loop()だった。
結果どうなったかというと、実戦のリポジトリでEMAをゼロから作り直す羽目になった。この話は最後の「テンプレートを直した」の節で回収する。
① Claudeに課金しよう
開発メンバーは全員AIエージェントを使っていた
まずこれを書いておく。開発(コードを書く部分)を担当した3人は、全員がAIエージェント前提で動いていた。自分はClaude Code、あとの2人はCodexを使っていた。AIを使うかどうかを議論する段階はもう終わっていて、「AIに何をやらせるか」で差がつく状態だった。
git履歴から測れる数字はこうなる。
| 指標 | 値 |
|---|---|
| mainコミットのうちClaudeとの共同作業 | 707 / 886(79.8%) |
| 自分のコミットのCo-Authored率 | 87.0%(571 / 656) |
| 夜間自動レビュー | 13本 / 4,876行(2週間) |
| 夜間レビュー起因のPR | 15件 |
| 人間によるPRレビュー | 0件 |
正直に注記しておくと、確かな数字はこの「79.8%」だけだ。この集計はClaudeが自動で付けるCo-Authored-Byトレーラーを数えているだけで、署名を残さないCodexの利用量はgitからは測れない。他の2人のAI利用は本人たちの証言による。
夜間レビューを毎晩走らせた
課金の効きどころは、人間がやらない仕事をAIに回せることだった。その代表が夜間レビューだ。
毎晩JST3時台に、その日のmainの差分を監査させて、レポートをブランチに置かせた。翌朝それを読んで、対応するものとしないものを仕分ける。2週間で13本、合計4,876行のレポートが出た。
レポートの冒頭には、毎回この前提が印字されていた。
このレポートは「コードを直接変更しない」前提の差分監査。指摘の根拠は実体ファイルの
`path:line` 引用で示し、推測は「要調査」として明記する。コードを触らせないのが重要だった。触らせると朝起きたときに「何が変わったか分からないmain」ができあがる。指摘だけさせて、直すかどうかは人間が決める。
指摘の消化も台帳化した。progress.mdにこう書き残す運用にしていた。
- 2026-05-19: 夜間レビュー PR #8 の取り込み + 残存指摘6件中6件対応。
  保留6件: production/node_01/platformio.ini board 修正(実機ビルド検証要・3夜連続保留)...
「対応N件 / 保留M件」を毎回書くと、放置している指摘が自然に目立つようになる。上の「3夜連続保留」がまさにそれだった。目立たせたからといって必ず直るわけではないが、少なくとも「見て見ぬふりをしている」ことは自覚できる。
AIがチームの決定と個人提出物の矛盾を見つけた
いちばん効いた検出はこれだった。中間発表の直前、メンバーが個人で書いていた計画書がチームの決定と食い違っていることを、夜間レビューが見つけた。
### 1.1 (メンバーの個人計画書)の node_01 役割が SSOT と完全に矛盾(High)

(メンバーの)中間発表計画書は、node_01 を トランペット(楽器ノード)として扱い、
指揮者は「指揮棒用の別マイコン × 1」として分離する独自アーキテクチャを描いている。
...
つまり「指揮棒を別マイコンに切り出す」案は ADR-0003 を覆す設計変更に相当する。
中間発表でレビュアーがこの計画書だけ読むと、現行実装(node_01 = 指揮者)と齟齬を起こす。人間だと、他人の提出物と自分の実装コードを突き合わせて読む作業はまずやらない。時間もかかるし、指摘するのも気まずい。AIは気まずくならないので、こういう検出に向いている。
このチームは33件のPRに対して人間のレビューが0件だった。それは自分がレビュー文化を作れなかったという反省でもあるが、事実として実質的なレビュアーはAIだった。
AIの提案を実測で棄却した
課金の話をするとき「AIにやらせた」だけを書くと薄くなる。効いたのは逆で、AIの出力を疑う仕組みを持っていたことだった。
同期の遅延対策で、AIは3案を出してきた。先読み時間の拡大・ビーコン間隔の短縮・minフィルタ化。3つとも実装して実測した。結果、ビーコン間隔の短縮はバースト周期を1msも変えなかった。実測でそう出たので、実装済みのコードを撤去した。
コミットはこう残っている。
[修正] SoftAP ビーコン 50TU 設定を撤去 (MOP5 対処案2 の取り下げ)3案のうち効果が実証された2案だけを最終構成に残した。この「棄却した」という事実が、あとで報告書のいちばん強い材料になった。
AIが作った集計スクリプトを疑ったら、計測方式が間違っていた
もう1つ。評価指標の集計をPythonスクリプトでやらせていたのだが、その出力の数字が直感と合わなかったので、別経路の手計算で検算した。
そうしたら計測方式そのものが間違っていた。受信時刻と発火時刻を混同していて、測っている量が違っていた。7月10日、発表の直前に計測パイプラインごと再構築した。
[改善] 計測を発火時マスター時刻ベース (M45R/M45F) に一本化AIが出した数字をそのまま報告書に載せていたら、評価の章がまるごと嘘になっていた。
AI利用は隠さず申告した
授業側にはAI利用の申告義務があった。隠すものではなく申告するもの、という前提だったので、報告書に独立した節を立てて書いた。
書いたのは「AIを使いました」ではない。AIをどう疑ったかを書いた。報告書からそのまま引用する。
同期改善策としてAIが提案した3案(先読み時間の拡大・ビーコン間隔の短縮・minフィルタ化)のうち,ビーコン間隔の短縮は実測でバースト周期を1 msも変えないことを確認して撤去し,効果が実証された2案のみを最終構成に残した。
評価ルーブリックには「開発支援ツールの活用と検証」という項目があった。提出前にAI自身に採点者役をやらせて自己採点したところ、この項目は満点判定だった。講評は「AI提案の実測棄却まで示す。満点相当」。
課金で買えるのは「常時走らせられる状態」だけ
念のため書いておくと、課金すれば勝てるわけではない。
課金で買えるのは「AIを気兼ねなく常時走らせられる状態」だけだ。何を走らせるか、出てきたものをどう検算するかは自分で決めるしかない。上の4つのエピソードは全部、AIの出力を疑う手続きを先に決めていたから成立している。
② コーディングを始める前に、規則と担当範囲を決めよう
4本の柱のうち、いちばん効いたのはこれだと思っている。
成果から先に書く。事前に担当箇所とデータ形式をかなり細かく決めておいたおかげで、他の班より圧倒的にスムーズにプログラムの結合ができた。同じ授業の別の班では、担当ごとに書いたコードを最後に合体させようとして噛み合わず、結合の段で相当苦労している様子だった。
差がついたのは実装力ではなく、書き始める前に決めた量だったと思う。
担当は「人数」ではなく「コンポーネント」で切る
やってはいけないのは、1つのプログラムを人数で割ることだ。「このファイルはAさん、この関数はBさん」と切ると、境界がコードの内部を走ることになり、結合で必ず揉める。
うちの班はこう切った。
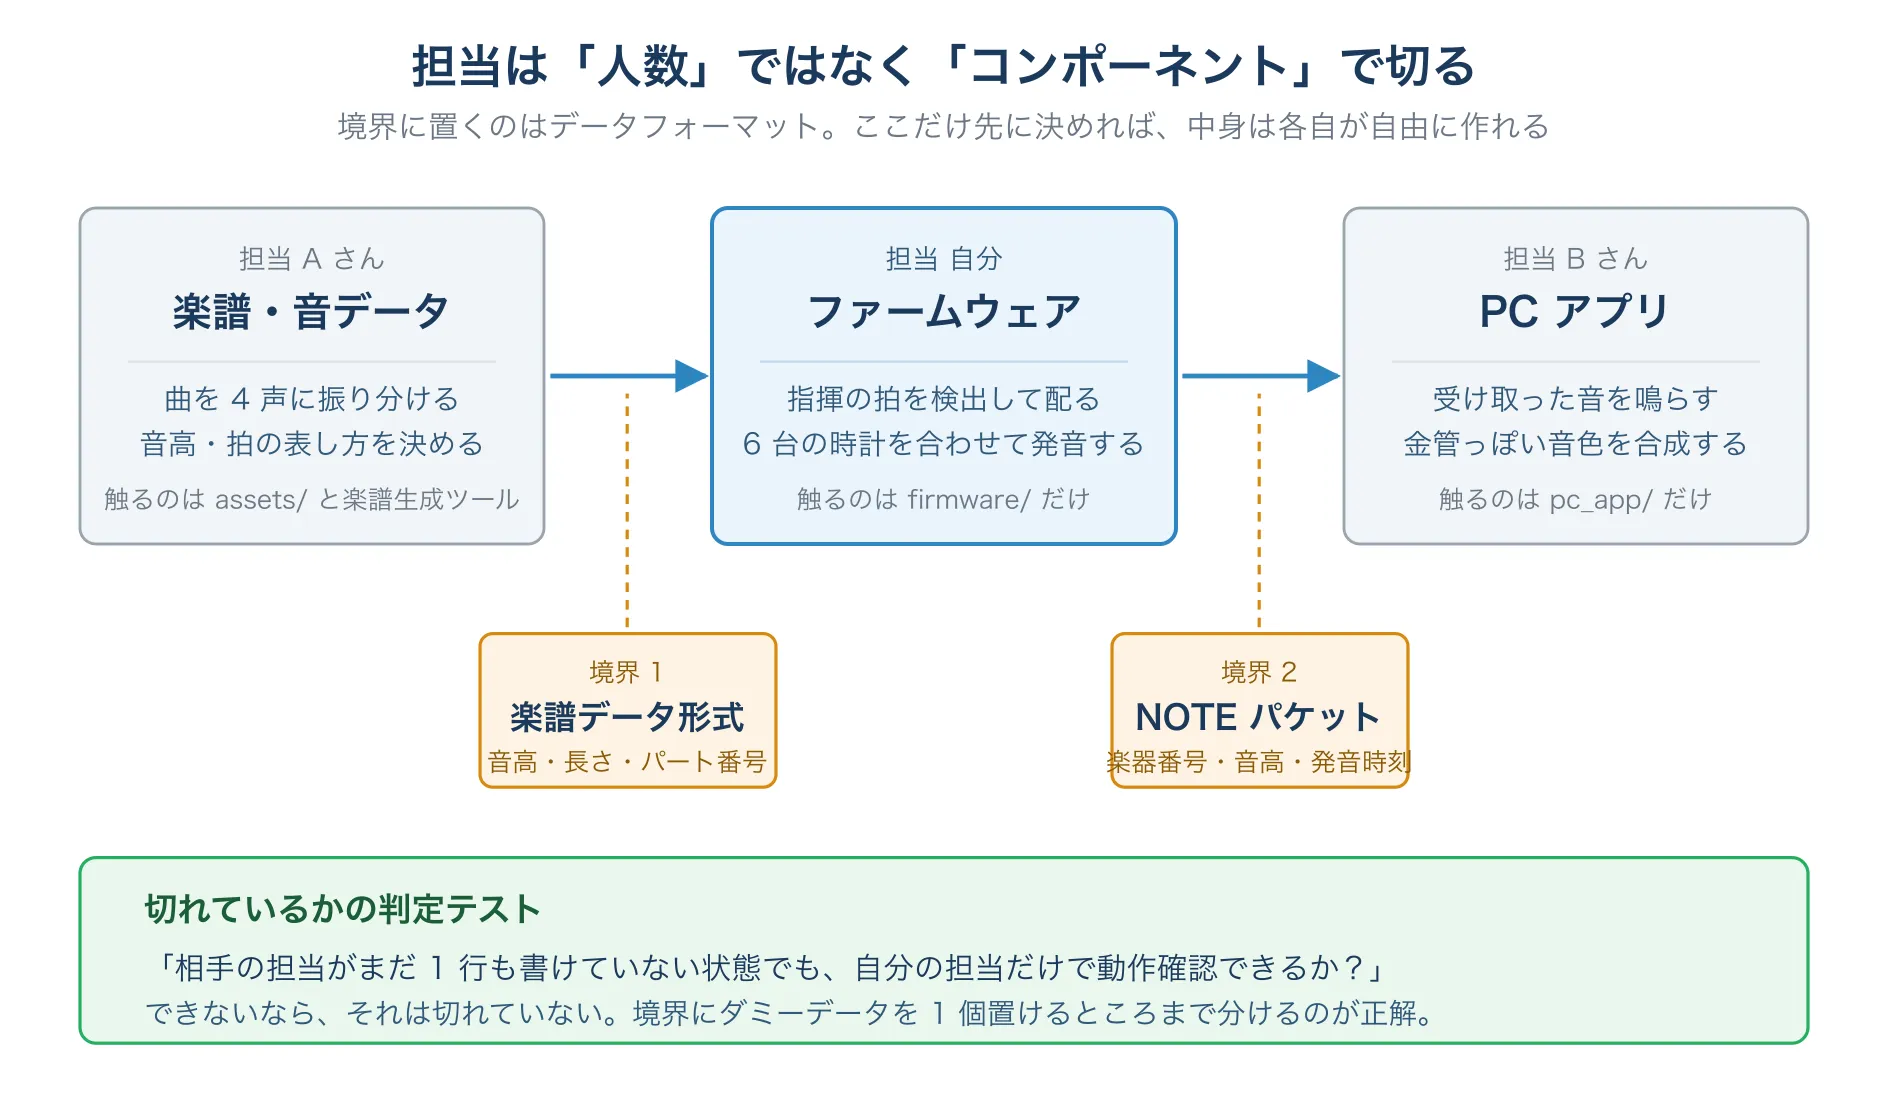
- ファームウェア(自分): 拍の検出、6台の時計合わせ、発音の予約
- 楽譜・音データ(Aさん): 曲を4声に振り分ける、音高と拍の表し方を決める
- PCアプリ / Processing(Bさん): 受け取った音を鳴らす、金管っぽい音色を合成する
3つとも「入力と出力を1行で説明できる」塊になっている。そして触るディレクトリが分かれている。担当表にはこう書いた。
楽譜とProcessingは通信パケットを境界に連携します。
担当境界=インターフェースである、というのが言語化されている状態を先に作った。
切れているかどうかの判定は簡単で、こう聞けばいい。
相手の担当がまだ1行も書けていない状態でも、自分の担当だけで動作確認できるか?
できないならまだ切れていない。境界にダミーデータを1個置けるところまで分けるのが正解になる。
境界のデータフォーマットを先に確定する
コンポーネントを切ったら、次にやるのは実装ではなくフォーマットの確定だった。音データと楽譜データの形式を全体で決めてから、コードを書き始めた。ここがスムーズさの正体だったと思う。
決めたのは「誰が実装するか」ではなく、コンポーネントの間を何が流れるかのほうだ。楽譜データなら音高・長さ・パート番号をどう持つか。PCへ送る音データなら、楽器番号・音高・発音時刻をどの順に並べるか。ここさえ確定していれば、実装の途中で「そこ決まってないんだけど」と言って手が止まることがない。
逆に言うと、フォーマットが決まっていない状態で書き始めると、各自が自分の都合のいい形を仮置きしてしまう。仮置きは必ず食い違うので、結合のときにどちらかが書き直しになる。
もう1つ効いたのは、フォーマットを決めた直後にダミーデータを1個作ることだった。楽譜形式が決まったら、その形式のサンプルを1曲ぶん置く。そうするとPCアプリ側はファームウェアの完成を待たずに実装を進められる。
ファームウェアの中を分担するなら、関数レベルまで決める
うちの班はファームウェアの中を分担しなかった。マイコン6台ぶんのコードは自分が通貫で設計・実装した。担当表にもそう明記してある。
Arduino側は共通モジュールとノード差分を揃えるため、(筆者)が通貫して設計・実装する方針でした。
ただ、班によっては人手の都合でファームウェアの中を分けざるを得ないこともある。その場合に必ずやってほしいのが、仕様を決める段階で「誰がどんな関数を作るか」まで決めておくことだ。
さっき書いた「別の班の結合が噛み合わなかった」というのは、たぶんここが原因になっている。各自が自分の書きやすい形で書くと、グローバル変数の持ち方も初期化のタイミングも呼び出し順もバラバラになり、合体させた瞬間に「誰のせいで動かないのか分からない」状態になる。マイコンは実機でしか症状が出ないので、切り分けにも時間がかかる。
依存関係で失敗しないよう、コード仕様はすごく慎重に決めたほうがいい。
そのための道具として、EMA(Embedded Module Architecture)を使うのを強くすすめる。自分で作って公開している組込み向けの設計パターンで、これを使うとクラス(モジュール)単位での分担開発が簡単に行える。
やっていることは3つだけだ。
- ハードウェア1個をクラス1個(モジュール)に閉じ込める
- 全モジュールが同じインターフェース(
IModule)を実装する - モジュール同士は直接呼び合わず、共有構造体
SystemDataを経由してだけやり取りする
loop()はこうなる。
void loop() {
    // ① 入力フェーズ: 外界からデータを取り込む
    for (auto* m : gInputs)  if (m->enabled) m->updateInput(gData);
    // ② ロジックフェーズ: SystemData だけを見て状態を更新
    applyPattern(gData);
    // ③ 出力フェーズ: SystemData を外界に反映
    for (auto* m : gOutputs) if (m->enabled) m->updateOutput(gData);
}
モジュールの抽象基底はこれだけ。
#pragma once
struct SystemData;

class IModule {
public:
    bool enabled = true;
    virtual ~IModule() = default;

    // ハードウェア初期化。成功で true。
    virtual bool init() { return true; }
    // 入力フェーズで呼ばれる。センサ値や受信結果を data に書く。
    virtual void updateInput(SystemData& data) { (void)data; }
    // 出力フェーズで呼ばれる。data の値をハードウェア/送信に反映する。
    virtual void updateOutput(SystemData& data) { (void)data; }
    // 後始末。基底側は空実装。
    virtual void deinit() {}
};分担開発でこれが効くのは、「モジュール同士の直接呼び出しは禁止」というルールがあるからだ。Aさんのモジュールが完成していなくても、BさんはSystemDataのフィールドを読み書きするだけで自分のモジュールを書き切れる。結合は「配列に1行足す」で終わる。
// 入力フェーズ: WiFi 受信 → IMU 読取
IModule* gInputs[]  = { &gNet, &gImu };
// 出力フェーズ: ロジック結果をパケット化 → LED 反映 → UDP 送信
IModule* gOutputs[] = { &gSender, &gLed, &gNet };結果として、4バージョンぶんのファームウェアにIModuleを継承したヘッダが48ファイルできたが、ユニークなモジュールクラスは7種で、全部〜Moduleという命名に揃った。誰が書いても同じ形になる。
初期化にも規約を1つ足した。失敗したモジュールは無効化して、残りだけで動かす。
constexpr size_t MAX_RETRY = 3;
void initWithRetry(IModule* m, const char* name) {
    bool ok = false;
    for (size_t i = 0; i < MAX_RETRY && !ok; ++i) {
        ok = m->init();
        if (!ok) delay(50);
    }
    m->enabled = ok;   // 失敗したモジュールは無効化して残りは動かす
    DBG_PRINTF("[N1 INIT] %s = %s\n", name, ok ? "OK" : "NG");
}
センサ1個の初期化に失敗しただけで、そのノードが丸ごと立ち上がらない状態を避けられる。実機を6台並べると、配線が1本甘いだけでその台が黙る、というのは日常的に起きる。
EMAそのものの詳しい話は別記事に書いてあるので、分担開発でマイコンを触る人はこちらも読んでほしい。
loop()に全部書くのをやめる組み込み設計パターンを自作した
決めたことはADRに残す
決めたことは全部ADR(Architecture Decision Record)にした。「何を決めたか」だけでなく「なぜそれにしたか」「何を採らなかったか」を書く形式にしてある。最終的に7件になった。
EMAを採用したADRの背景節はこう書いた。
担当者ごとに書き方がばらけると、以下の問題が起きやすい:
- ループ内で入力・制御・出力のコードが混ざり、テストと差し替えが困難になる
- ノード間で同じ機能(UDP受信・LED表示など)を別実装してしまう
- 状態管理が
global変数の山になり、担当者以外が読めなくなる授業期間内に6台を結合・同期させる都合上、共通の設計パターンを最初から固定し、責務分離とモジュール差し替えが効く形で書き始めたい。
採らなかった案も表にした。
| 代替案 | 採用しなかった理由 |
|---|---|
Arduinoベタ書き(setup/loopに全部) |
複数人開発で即破綻。テスト困難 |
| FreeRTOSタスクベース | UNO R4でも可能だが学習コストが重く、6週間の実装期間にはオーバーキル |
| 他のOSSフレームワーク | 本件は汎用ロジック + UDPが主で、音色合成はPC側。フィット感が薄い |
これを書いておくと、2か月後に「なんでFreeRTOS使わなかったんだっけ」となったときに議論が1周で終わる。ちなみに報告書の設計章はこのADRをほぼそのまま流用できた。
事故が起きてから作った規則もある
先に全部決められるわけではない。事故が起きてから足した規則もある。代表がこれ。
実機未テストの .ino / .cpp に Claude 起点で追加変更を入れないこと。
変更が必要なら必ず手元で pio run → 実機 upload までユーザー側で確認してから。

理由: 拍検出・WiFi・I2C は実機特性に強く依存する。机上のロジック修正で挙動が
逆転する事故が過去にあった。理由まで書いてあるのがポイントだと思っている。「禁止」だけ書くと、状況が変わったときに解除していいのか判断できない。「机上の修正で挙動が逆転する事故があったから」と書いてあれば、実機検証の仕組みができた時点でこの規則は緩められると分かる。
正直な話: 規則は書くだけでは守られない
ここからは失敗の話。規則を書いたからといって守られはしなかった。
コミットメッセージの規約([種別] 概要)はCONTRIBUTING.mdにも.agent/conventions.mdにも書いてあった。実際の遵守率はこうなった。
| 対象 | プレフィクスあり |
|---|---|
| 規約を書いた本人 | 94.5% |
| チーム全体 | 80.6%(886件中172件がプレフィクスなし) |
チーム全体では2割がプレフィクスなしだった。これは他のメンバーの問題ではなく、規約を書いた自分が「書いて共有した」で終わらせたという運用の失敗だ。
同じ形の失敗が他にもある。
- Issueテンプレートを3種類も用意したのに、Issueは0件。3か月で1件も起票されなかった
- ブランチ命名規約(
feature/fix/)を決めたのに、実際は人名ブランチが定着した - 「rebaseは使わない、mainの取り込みは常にmerge」と決めていたのに、共通祖先を持たない2つの履歴が1か月以上並走する事故が起きた(これは後述する)
ここから言えるのは1つで、規則は「機械で見る」までセットにしないと効かない。
- CIに落とせる規則(ビルドが通るか、秘匿情報が入っていないか)は落とす
- 落とせない規則(コミットメッセージの日本語の質、Issueを立てるかどうか)は、守られない前提で設計する
Issueが0件だった原因も今なら分かる。WBSの番号が別ファイルで管理されていて、GitHubと接続されていなかった。「タスクはWBSに書いてある」状態で「Issueも立てて」と言われても、二重管理にしかならないので誰もやらない。WBSの番号をIssue番号に対応させるところまで設計しないと回らなかった。
③ 徹底的にGitHubで管理しよう
何でもGitに入れた
コード以外も全部入れた。
- ファームウェア(239ファイル)とProcessingのスケッチ
- LaTeX報告書の
.texとビルド済みPDF - 議事録(PDFとAI要約Markdownの両方)
- 回路図(KiCad)
- 音色定義のJSON
- 実測CSVと発表用グラフのPNG
- 発表スライド
- AIの夜間レビューレポート13本
- AI向けの作業文脈(
activeContext.mdを120回、progress.mdを116回更新した)
追跡ファイルは1,142個になった。
PDFをコミットするのは賛否あると思うが、これは明確に理由を決めて規約化していた。
.texの変更とPDFの更新は同一コミットにまとめる(分けない)。 理由: Docker環境を持たないメンバーが提出物PDFを確認できないと提出・レビューが止まる。
チーム全員がLaTeX環境を持っているとは限らない。「ビルドできる人しか成果物を見られない」状態はレビューを殺す。リポジトリの肥大と引き換えに、全員が最新のPDFをブラウザで開ける状態を選んだ(この判断のツケは後述する)。
成果は最後のレポートで返ってきた
GitHub管理のいちばん大きい見返りは、開発中の便利さではなく最後のレポートだった。
最終報告書を書くとき、AIに渡したのはこの4つだけだ。
- 評価ルーブリック
- レポートの要件
- レポートのテンプレート
- リポジトリそのもの
この4つをAIに渡した。それだけで、質の高いレポートの下書きが出てきた。
なぜそれが成立したかというと、「どんな変更があったか」「なぜ変えたか」がコミット履歴とPRに全部残っていたからだ。886コミットとPR33件は、単なる作業ログではなくレポートの一次資料だった。
- 設計判断の根拠 → ADR 7件にそのまま書いてある
- 実装の経緯 → コミットメッセージに「なぜ変えたか」が書いてある
- 対策の効果 → 実測CSVとグラフがリポジトリに入っている
- 撤回した対策 → 「取り下げ」コミットが履歴に残っている
このレポートは100点中88点だった。GitHub管理を徹底した回収先は、開発中の効率よりもここだったと思っている。
普段のコミットメッセージを丁寧に書くのは面倒だが、あれは3か月後の自分に対する仕送りだった。
正直な話: 徹底できなかったこと
ここも正直に書く。「徹底的にGitHubで管理しよう」と言いながら、徹底できなかったところが3つある。
1. 履歴を書き換えたせいで、別々の履歴が並走した
これは記事の後半で書くpublic化と地続きの事故なので、先に結論を書いておく。機密を消すために履歴を書き換えたら、リポジトリが2つに割れた。
publicにする前に、履歴に入ってしまっていた授業の配布資料と個人の提出物を消す必要があった。.gitignoreに足すだけでは過去のコミットからは消えないので、履歴そのものを書き換えた。
ここで見落としていたのが、履歴の書き換えは全部のコミットハッシュを作り直すということだった。書き換え前の履歴を手元に持っている人からすると、それはもう「同じリポジトリの続き」ではなく、まったくの別履歴になる。
実際にそうなった。書き換え前後で、git logはほとんど同じに見える。
- author日時もコミット日時もメッセージも同一
- でもハッシュが違う
- そしてツリー(中身)は、消したファイルのぶんだけ違う
この「見た目は同じでハッシュだけ違う」コミットの対が、全ブランチを通して429組できていた。日付の内訳は4月162組・5月207組・6月60組。要するにそれまでの履歴ほぼ全部が二重になった。
そのまま6月24日、両方をマージして1本に戻した。progress.mdにはこう残っている。
分岐していた Git 履歴を統合・main へ push。共通祖先を持たない現行 main と
退避側の 398 コミットをマージし、退避側固有の 112 ファイルを復元。「共通祖先を持たない」というのが書き換えの証拠そのものだ。片側が398コミット、もう片側が372コミットあって、両者を繋ぐ地点が存在しない。結果、886コミットのうち382件(43%)が「同じコミットメッセージがどこかで重複している」状態になり、git logから履歴を追うのが実質的に不可能になった。
そして一番まずいのはここだ。 マージした時点で、書き換えで消したはずのファイルが戻ってきた。
| 消そうとしたもの | 統合後のmainでの状態 |
|---|---|
授業の配布資料(references/lectures/) |
0ファイル(消えたまま) |
個人の作業ログ・提出物(work/<個人名>/) |
数百ファイルが復活 |
書き換えたのは自分の手元だけで、他のメンバーのローカルには書き換え前の履歴が残っていた。それをマージすれば、当然もとに戻る。履歴の書き換えは、全員が同時にやらないと意味がない。
ここから引き出せる教訓は2つある。
- 履歴の書き換えは「消す」ではなく「割る」操作だと思ったほうがいい。 どうしてもやるなら、全員の作業を止めて、全員に消して clone し直してもらうところまでが1セットになる
- だから本当の対策は「入れない」しかない。 消せる前提で入れると、消したつもりのものが残る
分岐に気づく方法だけは覚えておくと早く手を打てる。
# ローカルとリモートがどれだけズレているか
git log --oneline origin/main..main | wc -l
git log --oneline main..origin/main | wc -l

# 共通祖先があるか(何も出なければ別履歴)
git merge-base main origin/main
2. .gitが134MBに膨れた
原因は4つ。
- LuaTeXのフォントキャッシュ(約15MB)がコミットされていた。
.gitignoreに.texmf-var/とluatex-cacheが入っていなかった - Git LFSを一切使っていなかった。5MBのPDFを更新のたびにコミットしていた
- 同じ内容のPDFを
main.pdfと提出用リネーム版の2本立てで管理していた(各5MB) - 上の履歴書き換えと統合で、400コミット近くが二重に積まれた
.gitignoreは3か月で28回も後追いで直している。最初から厚くしておけば済んだ話だった。
3. PRは使ったが、レビューは機能しなかった
PRは33件作ったが、全部自分が作って自分でマージしていた。人間のレビューは0件、コメントも3件だけ。PRという仕組み自体もチームには広がらず、人名ブランチに直接コミットしてローカルでgit mergeする運用に落ち着いた。PRを通す理由(CIが走る・差分が1画面で読める・履歴に単位が残る)を、自分が説明しきれていなかったのだと思う。
PRは「レビューを受ける場」ではなく「変更の単位を切る / CIを通す / 履歴に残す」ためだけに使われていた。それでも価値はあった(PR単位の差分がレポートの材料になった)が、レビュー文化は作れなかった。
④ PlatformIOを使おう
これを4本目の柱に置いているのは、環境の再現性が想像以上に効いたからだ。
一番のメリットは「誰のPCでもすぐ動く」
platformio.iniがリポジトリに入っているので、どのPCでもcloneして一発でコンパイルが通り、そのまま書き込めた。
具体的な体験としてはこうなる。新しいPCで作業したくなったとき、やったのはVS Codeに拡張機能を入れただけだった。ライブラリマネージャもボードマネージャも一切いじっていない。cloneして、開いて、ビルドボタンを押したら、すっと書き込めた。
Arduino IDEでチーム開発をやったことがある人なら、ここが何を意味するか分かると思う。Arduino IDEだと各自がボード定義とライブラリを手で揃える作業が必ず発生する。「動かないんだけど」「ライブラリのバージョンいくつ入れた?」「ボードマネージャからESP32入れた?」という往復が、新メンバーが増えるたび・PCを変えるたびに発生する。
この往復が丸ごと消えた。
チーム開発では、これは言わずもがなの効きどころだった。6台のマイコンを複数人で触る前提だと、「自分の環境だと動かない」が1回起きるだけでその日の作業が半分溶ける。
platformio.iniが全部を明文化する
テンプレートに入れてあるplatformio.iniはこうなっている。
[env:uno_r4_wifi]
platform = renesas-ra
board = uno_r4_wifi
framework = arduino

; ===== EMA を使うために必要な 2 行 =====

; 全ノード共通のライブラリ(firmware/common/lib/)を読み込む
lib_extra_dirs = ../common/lib

; include/ を各モジュールからも見えるようにする。
; PlatformIO は include/ を src/ にしか通さないため、この 1 行が無いと
; common/lib/ や lib/ の中の .cpp から SystemData.h が見つからない。
build_flags = -I includeボード・フレームワーク・依存ライブラリ・インクルードパスが全部このファイルに書いてある。環境が口伝ではなくファイルになる。
ちなみにbuild_flags = -I includeの1行は、テンプレートを直しているときにCIで落ちて気づいた。PlatformIOはinclude/をsrc/にしか通さないので、これがないとcommon/lib/の.cppからSystemData.hが見つからない。こういうハマりどころも、platformio.iniにコメント付きで書いておけば次の人は踏まない。
PlatformIOが残り3本を支えている
冒頭の図に戻る。PlatformIOを土台に置いたのは、上の3本と全部つながっているからだ。
柱③(GitHub管理)と接続する。 Arduino IDEと違い、プロジェクトが普通のテキストファイル構成になる。.inoのスケッチブックという独自の入れ物ではなく、src/・include/・lib/・platformio.iniというただのフォルダとファイルだ。だから差分がGitで読めるし、PRでレビューできるし、CIでビルドできる。
柱②(規則・担当)と接続する。 依存ライブラリとボード設定がplatformio.iniに明文化されるので、「そっちでは動くのに、こっちでは動かない」が構造的に起きない。EMAのlib_extra_dirsもここに書く。共通ライブラリをどこから読むかがファイルに書いてある状態は、それ自体が担当境界の定義になっている。
柱①(AI運用)と接続する。 pio runでCLIからビルドできるので、AIがビルドして、エラーを読んで、直して、また通すところまで自走できる。GUIでビルドボタンを押す必要があるとここで人間が必要になる。夜間レビューを回せたのも、CLIでビルド検証ができる前提があったからだ。
そしてEMA自体もPlatformIO前提のリファレンス実装になっている。柱②で紹介したlib_extra_dirsによるモジュール共有は、PlatformIOのライブラリ解決機構をそのまま使っている。
土台が崩れると上の3本が同時に効かなくなる、というのはそういう意味だ。
実戦でいちばん大きかった穴 — public化
ここまでで4本の柱は書いた。最後に、テンプレートには書いていなかったせいで一番痛かった穴の話をする。
6月23日、リポジトリをprivateからpublicにした。教員に成果物を見てもらうためだった。
そのとき初めて「このリポジトリ、公開して大丈夫だっけ」を全部見直した。結果はこうだった。
- 学籍番号を含むファイル: 53個
- 実名を含むファイル: 31個(ファイル名に実名が入っているものもあった)
- git authorに学内メールアドレスが残っていた。学籍番号がそのままアドレスになっているやつで、これは全コミットに刻まれて消せない
- 授業の配布資料(著作権物)がリポジトリに入っていた
このうち授業資料と個人の提出物を履歴から消そうとして起きたのが、柱③で書いた履歴が2つに割れた事故だった。提出前日には「リポジトリ内パス記載を全廃」というコミットも打つ羽目になった。この記事を書くにあたって、そのリポジトリはprivateに戻してある。公開したままにできる状態ではなかった、というのが結論だ。
ここで学んだのは、順番が逆だったということだった。
- ❌ 最後にpublicにできるか点検する
- ✅ 最初からpublicでも平気な状態で運用する
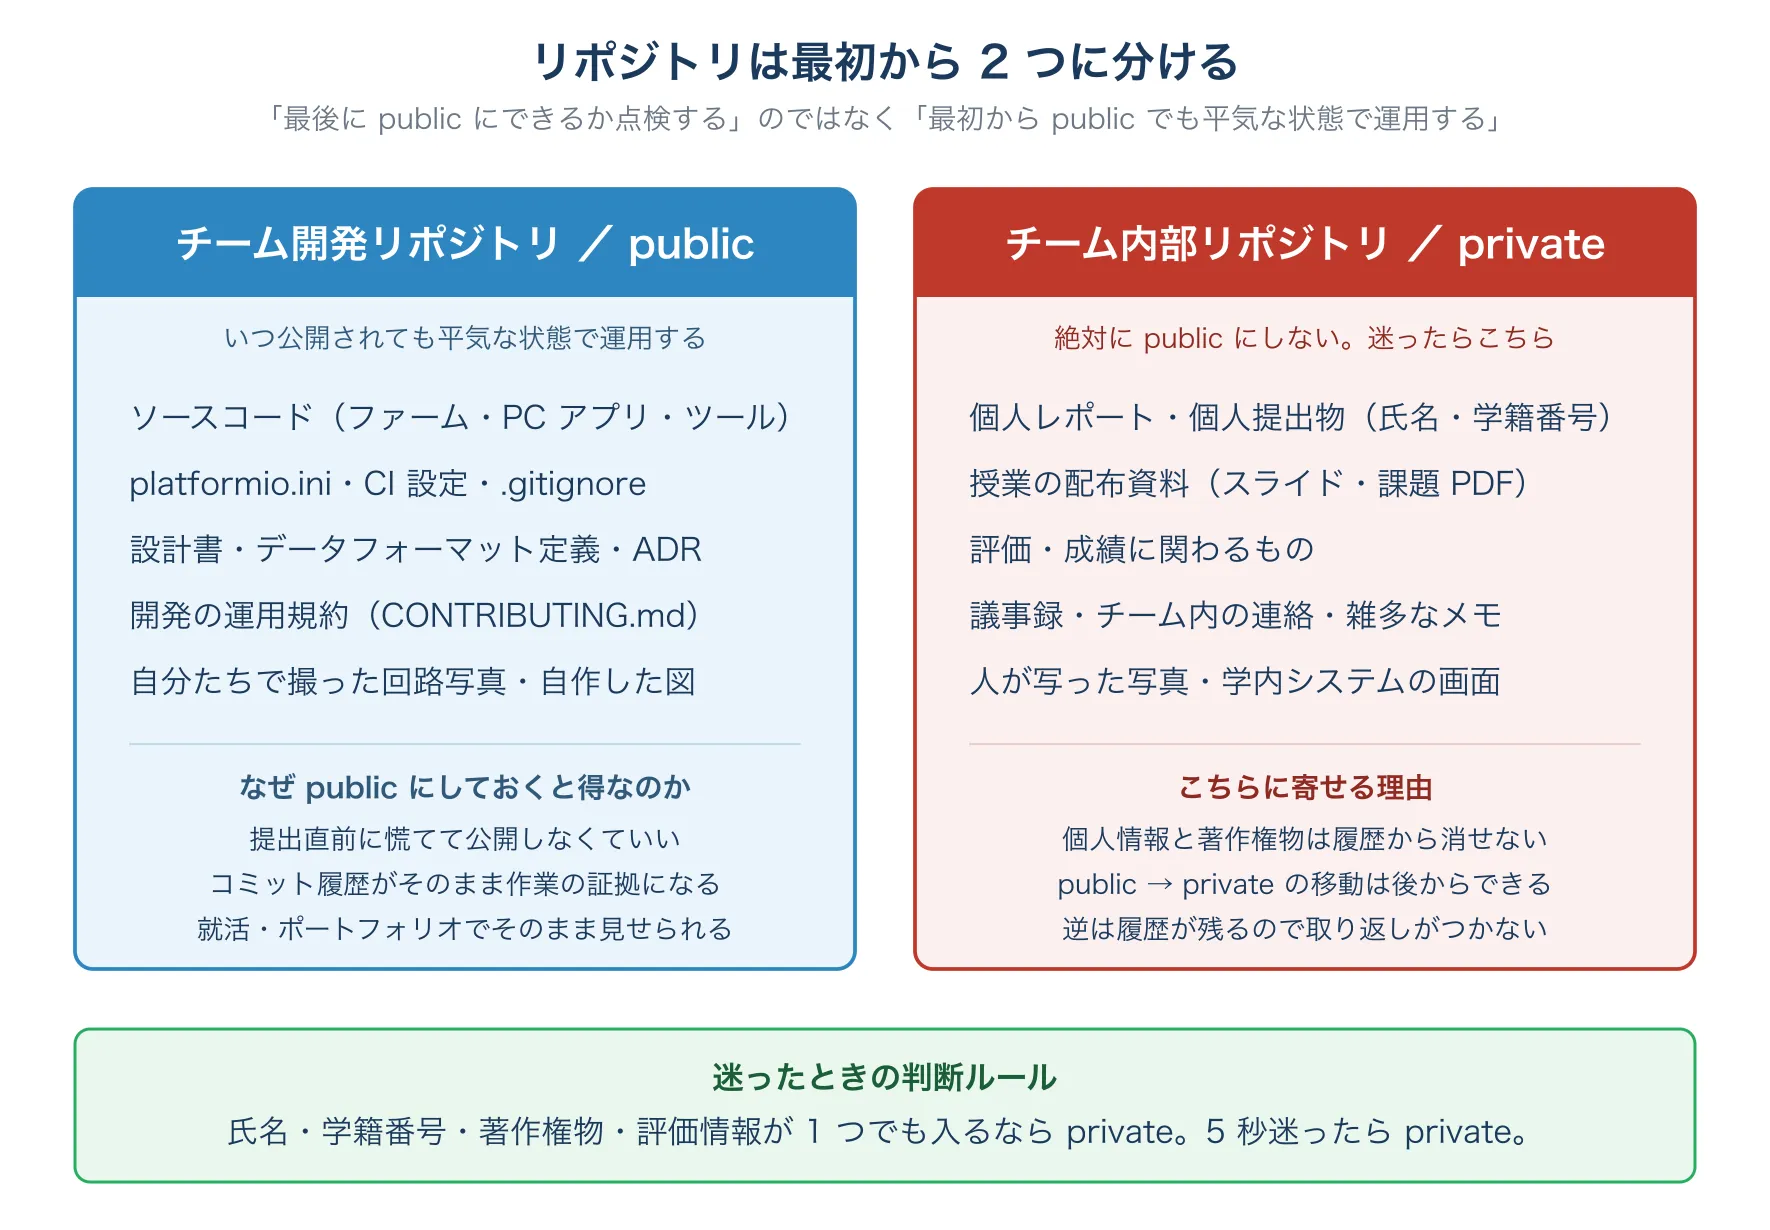
そして「public前提で運用する」を成立させるには、publicに置けないものの行き先を先に用意しておく必要がある。だからリポジトリを2つに分ける。
線引き表
来年やる人のために、そのまま使える形で表にしておく。
| 置くもの | 行き先 | 理由 |
|---|---|---|
| ソースコード(ファーム・PC側・ツール) | public | 成果物の本体・見せたいもの |
platformio.ini・CI設定・.gitignore |
public | 環境再現と機械ゲートの一部 |
| 設計書・データフォーマット定義・ADR・運用規約 | public | チームで作った一般文書 |
| 自分たちで撮った回路写真・自作した図 | public | 自分たちの著作物 |
| 個人のレポート・提出物(氏名・学籍番号入り) | private | 個人情報 |
| 授業資料(講義スライド・配布PDF・ルーブリック) | private | 著作権物・再配布不可 |
| 評価・成績に関わるもの | private | 他人の情報を含みうる |
| 議事録・チーム内連絡(人名が入りがち) | private | 個人情報が混ざりやすい |
| 写真・スクショで人・学内画面が写るもの | private | 写り込みリスク |
判断ルールは1行で覚えられる。
氏名・学籍番号・著作権物・評価情報が1つでも入るならprivate。公開されて困るか5秒迷ったらprivate。
publicに置いてよかったものをprivateに置いてしまうのは後から移せる。逆は履歴が残るので取り返しがつかない。だから迷ったらprivate側に倒す。
見落としやすいのはこの3つ
実際にやってみて、抜けやすかったのはここだった。
1. ファイル名にも学籍番号・実名を入れない
第1回議事録_<学籍番号>.pdf のようなファイル名は、ファイル名自体が個人情報になる。中身を伏せてもファイル一覧で丸見えになる。誰が作ったかはコミットのauthorで分かるので、ファイル名には入れなくていい。
2. コミットのauthorメールアドレスは全部見える
git config user.emailに設定したアドレスは全コミットに刻まれて、publicで読める。大学から配られた学内メールを設定すると、それが履歴に永久に残る。うちはこれをやってしまった。個人のGmailかGitHubのnoreplyアドレスを使うべきだった。
3. 個人のレポート作業を「ついで」にpushしない
個人レポートにはほぼ確実に氏名・学籍番号・所属が書いてある。チームリポジトリで作業しているとつい「ついでにコミット」してしまう。最初からprivate側で作業するのが唯一の確実な対策になる。
機械で見る
そして人間の注意力に頼らない。柱②で書いた「規則は機械で見るまでセットにしないと効かない」がここにも当てはまる。
テンプレートには秘匿情報スキャンのCIを入れた。学籍番号らしき文字列・メールアドレス・APIキーらしき文字列を検知したらPRが落ちる。
name: Secret Scan

# 個人情報・秘匿情報が public リポジトリに入るのを防ぐ機械ゲート。
#
# 【重要】これは「push したあとに気づく」ための最後の砦であって、
# 一度 push すると履歴に残る。履歴から消すには全員の作業をやり直させる操作が要る。
# 本当の対策は「入れない」こと。

on:
  push:
  pull_request:
  workflow_dispatch:

jobs:
  scan:
    runs-on: ubuntu-latest
    steps:
      - uses: actions/checkout@v4
      - name: Scan tracked files
run: bash .github/scripts/secret_scan.sh検知パターンは外部ファイルにしてあるので、自分の大学の学籍番号の形式に合わせて最初に調整する。ここだけは各校で違う。
テンプレートを直したので、来年ぜひ使ってほしい
実戦で分かった穴を、全部テンプレートに戻した。16コミット、58ファイル、+3,463行。CIは2本とも緑になっている。
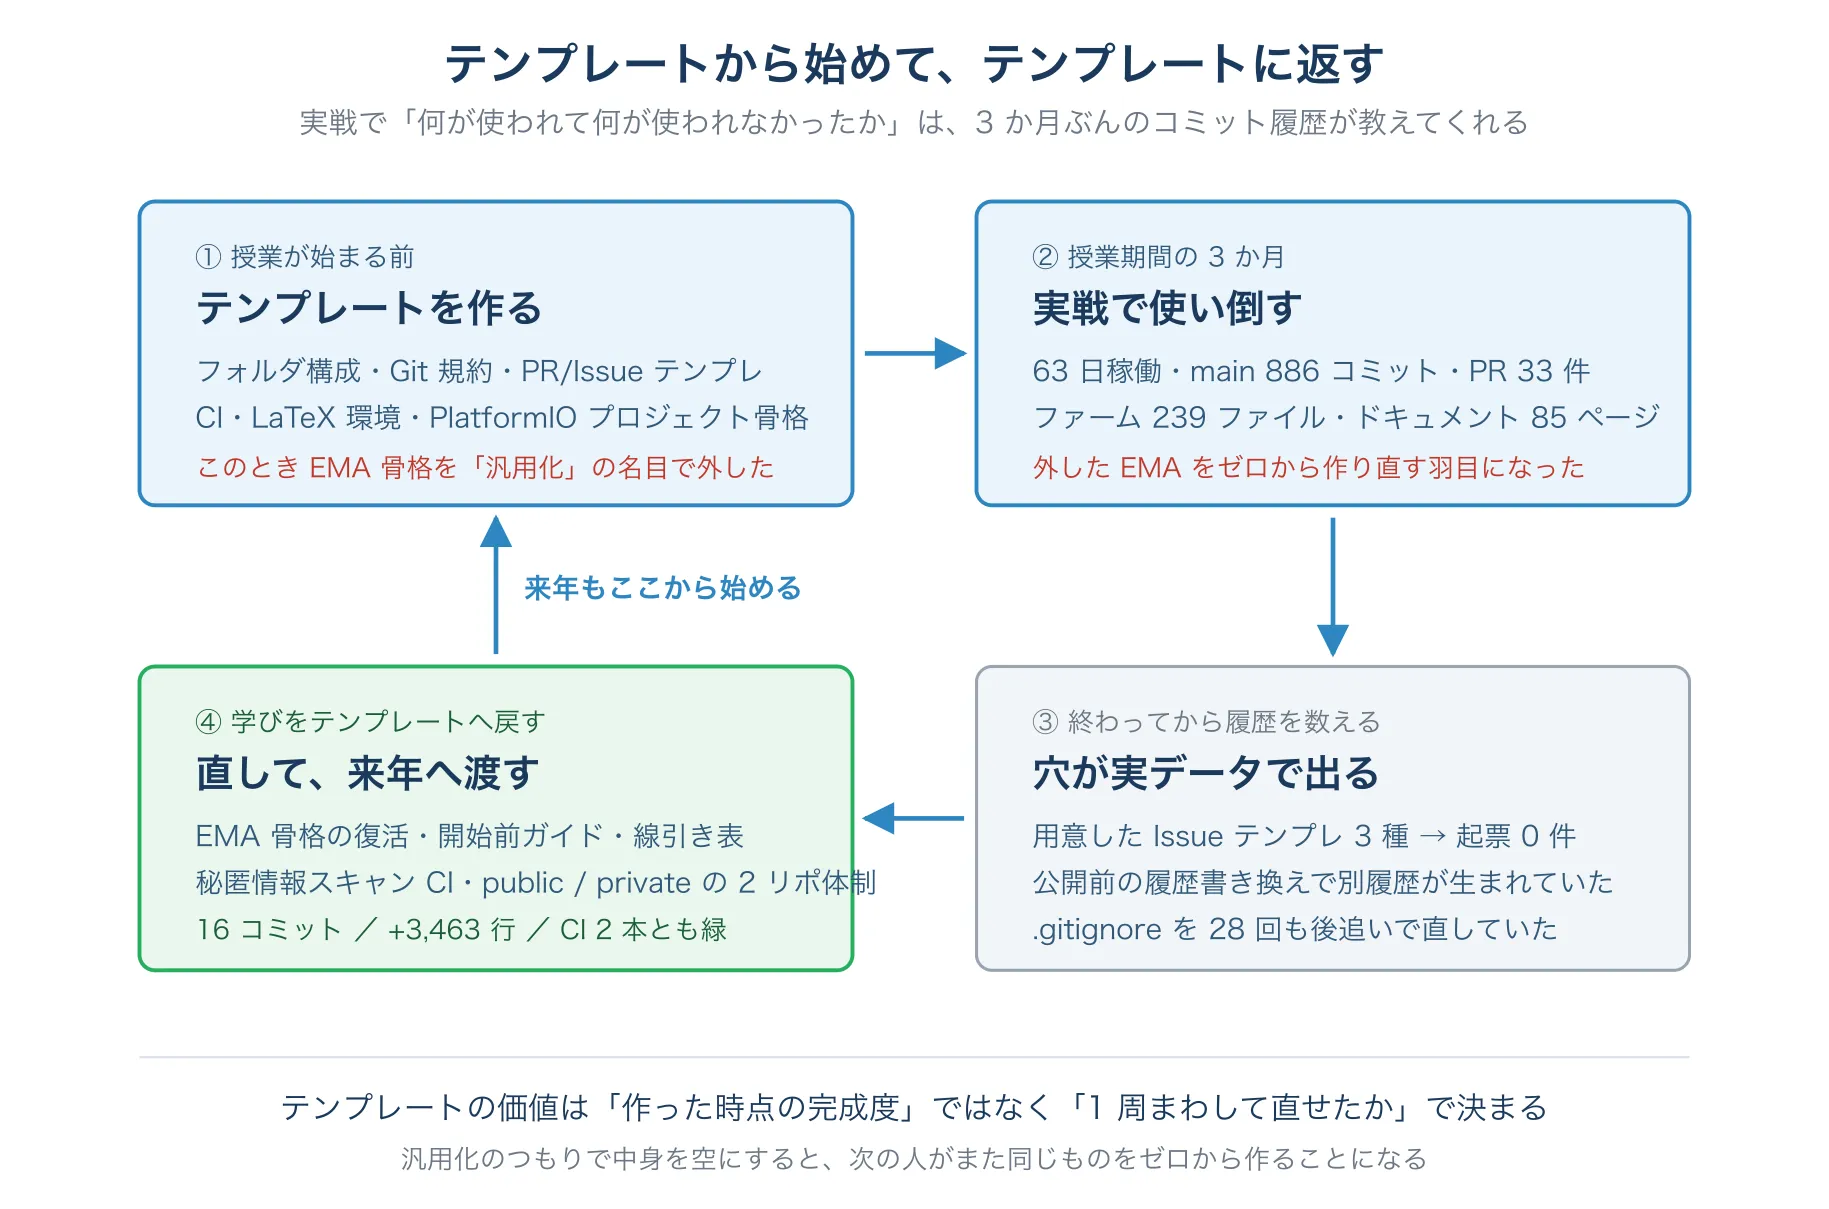
直した柱は4つ。
① EMA骨格を復活させた
冒頭で書いた「汎用化のために外して、実戦で作り直す羽目になった」の反省を回収した。firmware/common/lib/に骨格を戻し、動くサンプルを3種類置いた。
| サンプル | 何を見せるか |
|---|---|
ButtonModule |
入力だけを持つモジュール |
LedModule |
出力だけを持つモジュール |
SerialLinkModule |
入力と出力の両方を持つモジュール(通信はたいていこれ) |
この3つを1つのmain.cppに組み込んであって、ボタンを押すとLEDが点滅し、長押しで点灯に変わり、PCからON/OFFを送ると直接操作でき、100msごとにSTATUS,<値>をPCへ送る、というところまで動く。
さらにPC側のスケッチも同じプロトコルで繋がる状態にしてある。ファームウェアが送るSTATUS,<値>をProcessing側が受けて表示するところまでが1本の実例として通っている。柱②で書いた「境界のデータフォーマットを先に決める」を、テンプレート自身が実演している形にした。
汎用性を守りたいなら、READMEで「Arduinoを使わない班はfirmware/ごと削除してよい」と誘導すればいい。中身を空にして汎用性を確保するのは逆効果だった、というのが今回の結論だ。
② 「コーディング開始前に決めること」ガイドを足した
柱②の中身をそのままドキュメント化した(docs/before_coding.md、222行)。
- 担当はコンポーネント単位で切る(やってはいけない切り方 / 正しい切り方 / 切れているかの判定テスト)
- コンポーネント間のデータフォーマットを先に確定する(何を決めるのか / 決めた直後にダミーデータを1個作る)
- リポジトリに入れてよいもの / ダメなもの(線引き表と判断ルール)
- 開始前チェックリスト(全部チェックが入ったらコードを書き始めてよい)
そして記入式のテンプレートを2枚用意した。
docs/design/assignments.md— 担当表。コンポーネント名 / 入力→出力を1行で / 主担当 / 副担当 / 触るディレクトリを埋めるdocs/design/interfaces.md— インターフェース定義書。つなぎ目ごとに、フィールド定義 / 異常時の約束 / サンプルデータ / 変更履歴を埋める
担当表には副担当の欄を入れた。「主担当が倒れたときに引き継げる人」を必ず1人置く。1人しか分からない状態を作らないための欄で、これは今回の反省(ファームウェアを自分が通貫したせいで、自分が止まると全部止まる状態だった)から足した。
記入テンプレートは空の表 + 折りたたんだ記入例という形にしてある。実戦では、テンプレートの記入例をそのまま残したファイルが「もう書いてある」ように見えて放置され、実際のWBSは別ファイルに作られていた。空欄なら埋めるしかない。
③ public前提の運用を組み込んだ
線引き表・判断ルール・秘匿情報スキャンCI・.gitignoreの強化をまとめて入れた。.gitignoreには個人作業の置き場によく使われる名前(personal/・個人/・references/lectures/ など)を最初から入れてある。保険として効く。
.gitattributesにはGit LFSの手引きも書いた。134MBの.gitを作った反省がここ。
④ 「これは一例。変えてよい」と書いた
READMEに設計思想を明記した。
- 各フォルダは「こう分担すると開発がしやすい」という例
- サンプルコードは空のプレースホルダではなく、実際に動くものを置いている。「どう書けばいいか」を読んで真似できるようにするため
- いらないフォルダは削除してよい
- 各フォルダの
README.mdに「何のフォルダか・どう使うか・不要なら削除OK」が書いてあるので、迷ったらまずそれを読む
テンプレートは厳密な規格ではない。班によって運用が変わるのは当たり前で、「こんな感じでフォルダ構成すればいいんだな」が一目で分かる見本であればいい。そのうえで、後輩がこれ一式で立ち上がれるだけの手厚さは残した。
2リポジトリ体制にした
public前提の運用を成立させるために、テンプレートを2つに分けた。
| リポジトリ | 用途 |
|---|---|
| hackathon-template | public運用のチーム開発用。コード・設計・CI・報告書の雛形 |
| hackathon-template-private | private置き場用。個人レポート・授業資料・議事録・評価物 |
両方ともTemplate repositoryに設定してあるので、「Use this template」からそのまま新しいリポジトリを作れる。private側のテンプレートリポジトリ自体はpublicで公開しているが、これを元に作るリポジトリはprivateにするという使い方をREADMEに明記してある。READMEは相互リンクしてあるので、どちらから入っても両方に辿り着ける。
構成
public側の構成はこうなっている。
hackathon-template/
├── AGENTS.md                     AI 向けの動き方・重要パス・コマンド
├── CLAUDE.md                     @AGENTS.md の 1 行リダイレクト
├── CONTRIBUTING.md               Git 初学者ガイド(概念・履歴分岐事故・public 前提運用)
├── README.md                     使い始め手順・線引き表・設計思想
├── .agent/                       AI 向け詳細仕様 + 作業文脈(activeContext / progress)
├── .github/
│   ├── ISSUE_TEMPLATE/           task / bug_report / feature_request
│   ├── PULL_REQUEST_TEMPLATE.md
│   ├── scripts/secret_scan.sh    秘匿情報スキャン本体
│   ├── secret-scan-patterns.txt  検知パターン(大学ごとに調整する)
│   └── workflows/
│       ├── pio-build.yml         platformio.ini を自動探索してビルド
│       └── secret-scan.yml       秘匿情報スキャン
├── .devcontainer/                LaTeX コンパイル環境(Docker)
├── firmware/
│   ├── common/lib/
│   │   ├── ModuleCore/           EMA の骨格(IModule.h / ModuleTimer.h)
│   │   ├── LedModule/            出力だけを持つモジュールのサンプル
│   │   └── SerialLinkModule/     入出力の両方を持つモジュールのサンプル
│   └── node_01〜05/              platformio.ini + src/ + include/ + lib/
├── pc_app/
│   ├── common/SerialCore.pde     複数スケッチで共有する部品
│   ├── example_sketch/           ファームと同じプロトコルで繋がる実例
│   └── example_viewer/
├── docs/
│   ├── before_coding.md          コーディング開始前に決めること
│   ├── design/assignments.md     担当表(記入テンプレ)
│   ├── design/interfaces.md      インターフェース定義書(記入テンプレ)
│   └── decisions/0001-template.md  ADR の雛形
├── tools/verification/           評価・検証の型(シリアル収集 → 判定)
├── meetings/  hardware/  assets/
└── report/ LaTeX 報告書一式CIのビルド対象は、matrix直書きをやめて、platformio.iniを持つディレクトリの自動探索に変えた。実戦ではフォルダが増えるたびにmatrixを手で書き足す必要があったが、探索にしておけばプロジェクトが増えても勝手にビルド対象に入る。
tools/verification/には評価・検証の型を置いた。ハッカソン系の授業は必ず評価指標の実測が要求されるので、シリアルログを集めて判定するところまでの骨格があると最後が楽になる。うちは開発終盤にこれを自作して、報告書の評価章がまるごとそれで書けた。
まとめ
4本の柱をもう一度並べる。
- Claudeに課金しよう。 課金で買えるのは「常時走らせられる状態」だけ。人間がやらない仕事(夜間レビュー、他人の提出物との突き合わせ、検証スクリプトの生成)をAIに回して、出てきたものは必ず実測で検算する
- 書き始める前に規則と担当範囲を決めよう。 担当は人数ではなくコンポーネントで切り、境界のデータフォーマットを先に確定する。ファームウェアの中を分担するなら関数レベルまで決める。決めたことはADRに残す
- 徹底的にGitHubで管理しよう。 コードも図も実測CSVも報告書PDFも入れる。「なぜ変えたか」をコミットとPRに残しておくと、最後にレポートの材料として全部回収される
- PlatformIOを使おう。 cloneして一発でビルドが通る。この土台がないと、上の3本が全部効かなくなる
そして、いちばん言いたいのはこれだ。
テンプレートの価値は「作った時点の完成度」ではなく「1周まわして直せたか」で決まる。
初版のテンプレートは、汎用化のつもりでEMAを外し、記入例は書き換えられないまま放置され、public前提の運用という発想がまるごと抜けていた。それが分かったのは、3か月ぶんの履歴を数えたあとだった。
直したテンプレートはここに置いてある。
- hackathon-template — public運用のチーム開発用
- hackathon-template-private — private置き場用
来年この授業を受ける人は、まるごと持っていってほしい。そして1周まわして、また直してくれるとうれしい。